
Nat. Commun.:OMNI-P2x——激发态模拟的通用神经网络势
编辑说明: 本文在拟核科技Protomia的协助下完成编辑、中文翻译及适当内容扩展,基于原文进行适应性改写。完整原文信息及许可声明见文末免责声明。
近日,Nature Communications刊发了厦门大学Pavlo O. Dral教授、波兰华沙大学Joanna Jankowska教授与拟核科技联合团队的研究成果"OMNI-P2x universal neural network potential for excited-state simulations"。该工作发展了面向计算光化学的机器学习新方法。
摘要
光活性分子体系在现代科学与技术中发挥着至关重要的作用,广泛应用于太阳能电池、有机发光二极管、反应催化、光动力治疗等领域。光响应分子的理性设计需要理解驱动其运行的光物理和光化学过程,这通常需要通过第一性原理量子力学计算来获得。然而,此类计算对于高通量研究而言成本过高,成为发现新型光活性材料的主要瓶颈。为突破这一限制,本文引入OMNI-P2x:一种用于分子激发态和基态的通用神经网络势。OMNI-P2x可直接使用或经微调后用于执行广泛的光物理和光化学模拟。OMNI-P2x以远低于含时密度泛函理论(TD-DFT)方法的计算成本接近其精度,同时在激发态模拟方面比已有的半经验方法更准确、更快速。本文展示了其在紫外-可见吸收光谱、实时光动力学模拟以及可见光吸收偶氮苯体系的理性设计中的应用。
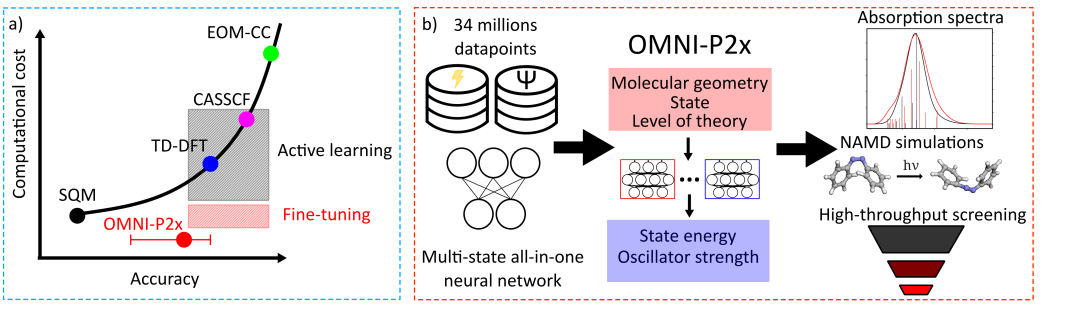
图1 | 用于激发态模拟的通用OMNI-P2x神经网络势及其在量子力学(QM)与机器学习(ML)方法层次结构中的定位。(a) OMNI-P2x及其微调在常用激发态模拟QM方法的计算成本/精度权衡中的定位:半经验量子化学方法(SQM)、含时密度泛函理论(TD-DFT)、完全活性空间自洽场方法及其衍生方法(CASSCF)、运动方程耦合簇方法(EOM-CC),以及主动学习;(b) OMNI-P2x的设计、训练及其应用能力概述。
在线体验 OMNI-P2x:Protomia 助力光化学模拟
编辑说明: 本部分由拟核科技Protomia补充添加,用于展示如何在 Aitomistic Hub 上使用 Protomia 进行 OMNI-P2x 计算。
您现在可以通过 Aitomistic Hub 直接在浏览器中运行 OMNI-P2x 计算——无需安装软件,无需命令行操作。
只需访问 aitomistic.xyz,用自然语言描述您的分子和计算需求,Protomia 将自动搭建并执行模拟。例如,您可以输入:
计算三苯胺的紫外-可见吸收光谱:先用 AIQM3 优化几何结构,再用 OMNI-P2x 计算激发态。
Protomia 自动处理整个工作流——从几何优化到激发态预测——并在数分钟内返回可视化结果。(OMNI-P2x 本身的计算仅需毫秒量级;总时间包含结构优化、光谱生成等步骤。)
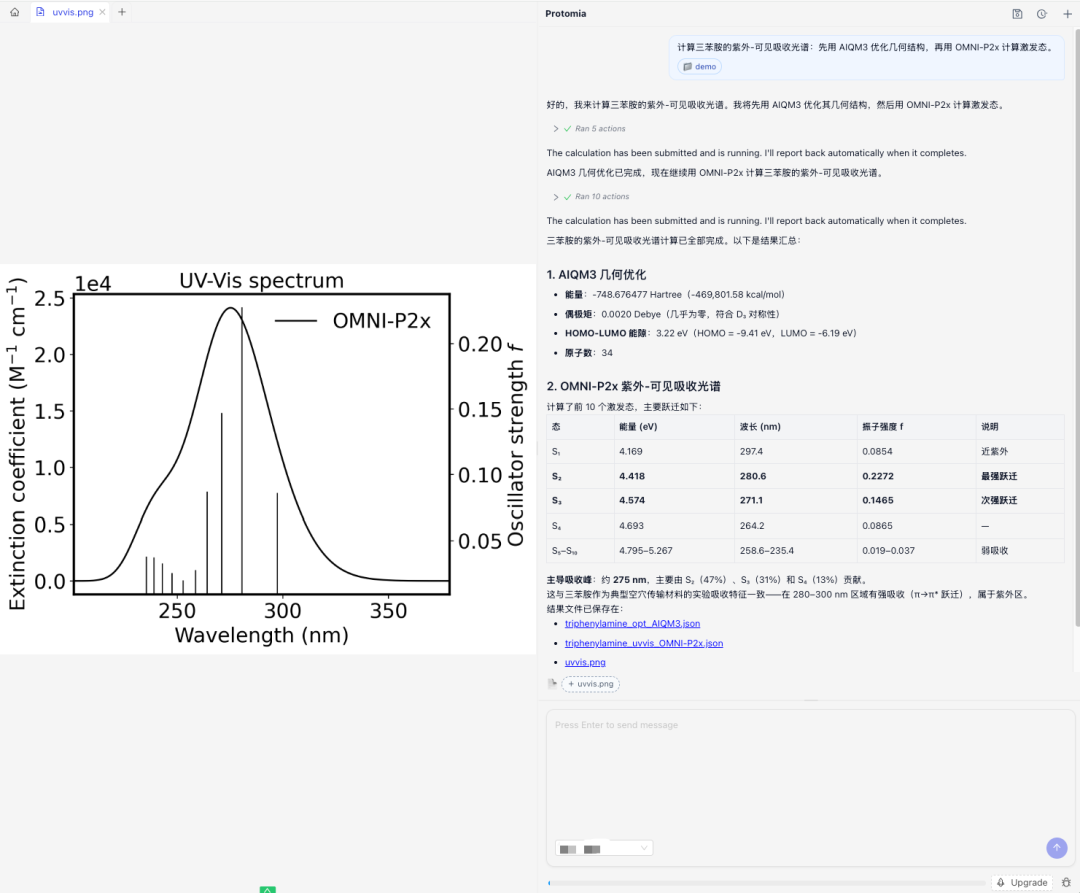
[截图:Aitomistic Hub 上的 Protomia 界面,展示紫外-可见光谱计算请求与结果]
编辑说明: 本部分由拟核科技Protomia补充添加。
对于希望在本地执行或将 OMNI-P2x 集成到自有计算流程中的用户,该方法作为 MLatom 程序的一部分免费开放——MLatom 是一个用于机器学习原子模拟的开源平台。
源代码: github.com/dralgroup/mlatom
教程: aitomistic.com/mlatom/tutorial_omnip2x.html
教程提供了通过 Python API 设置 OMNI-P2x 计算的分步指南,涵盖从基本的单点激发态能量预测到紫外-可见光谱生成、非绝热分子动力学等高级工作流。
引言
理论光化学利用量子力学(QM)方法准确预测分子电子激发态性质的能力,并提供对光-分子相互作用的深入理解。QM计算有助于更好地理解复杂过程,如光反应性和光稳定性、分子机器的运行、清洁能源产生中电荷载流子的分离,并进而为光材料(如有机发光二极管(OLED)、分子太阳能热能存储(MOST)系统和有机太阳能电池)提供理性设计原则。由于计算方法的广泛发展,它们不仅可用于解释和验证实验结果,还可指导光化学领域的新研究。
与此同时,阻碍理论方法在激发态性质预测中广泛应用的关键障碍是其计算成本,其精度/计算成本的权衡是一个关键挑战。尽管存在高精度方法,如运动方程耦合簇方法及其变体如ADC(2),但由于其陡峭的计算标度,它们最多只能用于中等大小的体系,需要数天或数周的计算时间。另一方面,含时密度泛函理论(TD-DFT)提供了一种更可负担的替代方案,通常可扩展到含约100个原子的体系,但代价是可靠性降低。最后,在精度-计算成本谱的低端,有半经验QM方法(SQM),例如基于忽略双原子微分重叠(NDDO)近似的一系列哈密顿量,如AM1、PM3、OM2和ODM2,与组态相互作用(CI)处理结合使用,以及含时紧束缚DFT方法TD-DFTB。虽然这些方法对于包含数百甚至数千个原子的体系确实更可负担,但其预测的准确性常常存疑。
当需要对光诱导过程进行实时模拟时,情况变得更加复杂,例如预测光开关量子产率、双光子动力学或激发态寿命。执行此类模拟最流行和广泛使用的技术是轨迹面跳跃(TSH),它是非绝热分子动力学(NAMD)的一种变体。在TSH中,一组独立的半经典轨迹被传播,并能够在绝热势能面(PES)之间切换(跳跃)。电子和核自由度通过所谓的态间耦合耦合在一起,控制着跳跃概率。运行面跳跃模拟需要使用能够准确预测多个PES并最好能正确描述锥形交叉附近波函数多参考特征的QM方法。这严重限制了理论方法的选择,通常使用CASSCF,而更慢但精度更高的微扰变体如CASPT2也可用。然而,由于驱动动力学需要在每个时间步计算能量和梯度,典型的模拟设置是数百条轨迹传播约1 ps,时间步长为0.1-0.5 fs,需要计算这些量数百万次,这仅对简单(通常是模型)体系可行。对于实验和技术相关化合物的模拟,迄今为止唯一可用的选择是半经验方法。
近年来,机器学习(ML)领域的进展在计算化学领域引发了显著的范式转变。将机器学习势(MLP)拟合到参考QM数据上,可以以极低的成本准确预测分子性质,如能量和能量梯度、偶极矩或电子密度,同时保持参考方法的精度。这突破了传统QM方法的限制,使得在更长的时间尺度上模拟更大、更复杂的体系成为可能。一类特别重要的新兴势是通用MLP,我们将其定义为在跨越化学空间的海量数据集上训练的模型,进而可用于对未见过的分子进行开箱即用的预测,从训练数据中泛化。
尽管使用MLP预测基态性质已逐渐成为常规任务,但将ML方法用于电子激发态则具有更大的挑战性,需要专家的人工监督。这是由于激发态势能面固有的复杂性,它们通常形成强相关的态流形,以非光滑的方式相互作用和混合。同时,应当指出,能够为激发态性质提供准确预测的模型,如SchNarc、SpaiNN或PyRAI2MD,已经开发并在TSH模拟中成功使用。然而,它们的能力局限于一次学习一个分子,即不能在化学空间之间迁移。
MS-ANI(多态ANI)模型的出现改变了这一局面,该模型被证明能够在同一模型中预测三种不同分子的非绝热动力学,为通用激发态势铺平了道路。最近,参考文献展示了创建可迁移神经网络用于激发态预测的另一种可能性。Axelrod等人也报道了可迁移的非绝热分子动力学模拟,然而其仅限于二氮杂苯光开关类分子。尽管激发态MLP取得了所有这些进展,它们仍远远落后于基态MLP,以至于许多专家质疑通用激发态MLP是否可能实现。人们普遍认同,开发这样的MLP将是一个重大突破。
在本文中,我们提出OMNI-P2x:一种用于分子激发态的通用神经网络(NN)势。我们通过结合多态学习和全合一学习的思想构建了OMNI-P2x。OMNI-P2x在激发态能量方面接近TD-DFT精度,在基态能量方面瞄准CCSD(T)质量:它可以开箱即用地预测紫外-可见吸收光谱,速度和精度均高于流行的半经验QM方法,使得ML激发态方法成为已有的经济高效QM方法(如半经验方法)用于高通量计算的可行替代方案。
我们利用OMNI-P2x的能力对500,000种化合物进行高通量筛选,以寻找具有红移可见光吸收的偶氮苯衍生物。这些体系由于其在非线性光学、光响应聚合物以及作为MOST化合物方面的应用而特别相关。OMNI-P2x在加速另一类广泛模拟——非绝热动力学方面的潜力也通过主动学习循环中对该通用势的微调得到了利用。该方法降低了生产级ML-TSH模拟的计算成本和实际耗时,同时提高了数据效率和模拟稳定性。
结果
模型架构与训练
OMNI-P2x模型的架构基于多态学习的思想及其在MS-ANI模型中的成功实现,后者专为准确高效地学习激发态能量和力而设计。多态学习可用于高效学习任意数量的电子态,同时利用整个神经网络来区分分子电子态,而非仅使用多输出模型中的最后一层。这一效果通过将额外的态排序数作为输入特征与包含几何构象信息的分子描述符一同纳入来实现。在此,我们扩展了该模型,使其能够跨多个QM水平学习,体现了最近引入的全合一(AIO)学习范式的精神。全合一学习已成功用于开发通用OMNI-P1神经网络势,能够进行接近DFT和CCSD(T)水平的预测,但仅限于基态能量和力。值得注意的是,从多个理论水平学习的能力提供了利用不同数量数据集的重要优势。在此,我们将两者结合:多态学习和全合一学习,获得了OMNI-P2x:omnipotential-2x,即用于激发态的全合一机器学习神经网络原子间势2。
OMNI-P2x基于已建立的ANI NN势。输入层由原子环境向量(AEV)组成,使用TorchANI Python包计算,以及两个额外特征:态排序数(如MS-ANI中所示)和一个代表QM水平的一热编码特征(对应全合一学习)。电子态编码为非负整数,与绝热态能量的自然排序一致,我们发现这既有物理动机,在经验上也比一热编码更准确。在本工作中,包含两个理论水平的数据:来自ANI-1ccx数据集的具有CCSD(T)/CBS精度的仅基态数据,以及来自PubChemQC数据集的TD-DFT B3LYP/6-31+G*激发态和基态数据。与所有ANI型模型一样,为每种化学元素训练一个单独的神经网络。在当前版本中,OMNI-P2x支持以下元素类型:H、C、N、O、F、S和Cl。预测按原子进行并求和得到分子的总能量。对于预测的能量部分,使用三个NN势的集成,将其预测结果平均以获得所有电子态的最终预测能量。对非共价结合结构应用碎片修正方案,以恢复激发能的正确强度性质,适用于被大于描述符截断半径的距离分隔的分子碎片,细节见方法部分和补充说明1。一个单独的MS-ANI型NN被训练并用于预测态间跃迁的振子强度。由于仅将TD-DFT数据用于激发态训练,该网络不包含额外的理论水平输入特征。
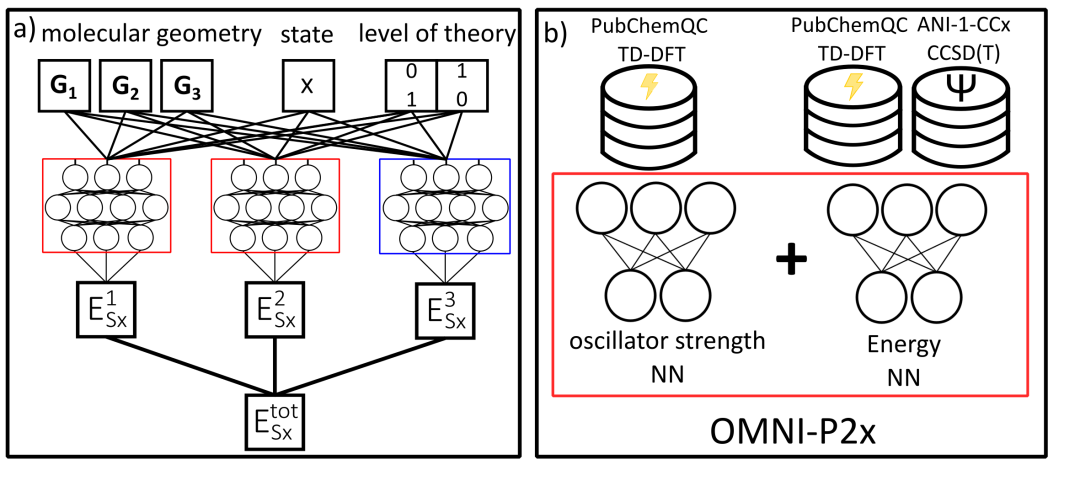
图2 | OMNI-P2x模型架构。(a) OMNI-P2x能量神经网络势的架构;(b) OMNI-P2x模型总结,包含分别预测振子强度和能量的独立神经网络,以及用于训练它们的数据集,标记为含时密度泛函理论(TD-DFT)或耦合簇单双激发微扰三重激发(CCSD(T))。
模型训练的数据来自两个数据集:1)PubChemQC项目数据集中的激发态数据,和2)ANI-1ccx数据集,包含约500,000个基态几何结构(含非平衡构象),其总能量在金牌标准CCSD(T)/CBS理论水平下计算。PubChemQC项目数据集包含在TD-B3LYP/6-31+G*理论水平下优化的独特分子结构,并使用TD-DFT计算了前10个激发态的能量和振子强度。我们使用了满足过滤标准的全部PubChemQC数据集(详见方法部分),得到310万个分子,每个分子有11个电子态。纳入ANI-1ccx数据集提供了关于非平衡几何变化对能量影响的重要附加信息,这对分子动力学和其他类型的模拟至关重要。ANI-1ccx数据集已被用作训练多个通用ML模型的基础,这些模型已成功用于分子动力学、几何优化和热化学计算。此外,两种不同类型数据集的组合允许覆盖更大的化学空间,即比较两个数据集中的数据分布(图3):ANI-1ccx数据覆盖小尺寸分子,而激发态训练数据的绝大部分由含15至45个原子的中等尺寸分子组成,其大多数激发能位于可见光谱的蓝端和紫外区域。
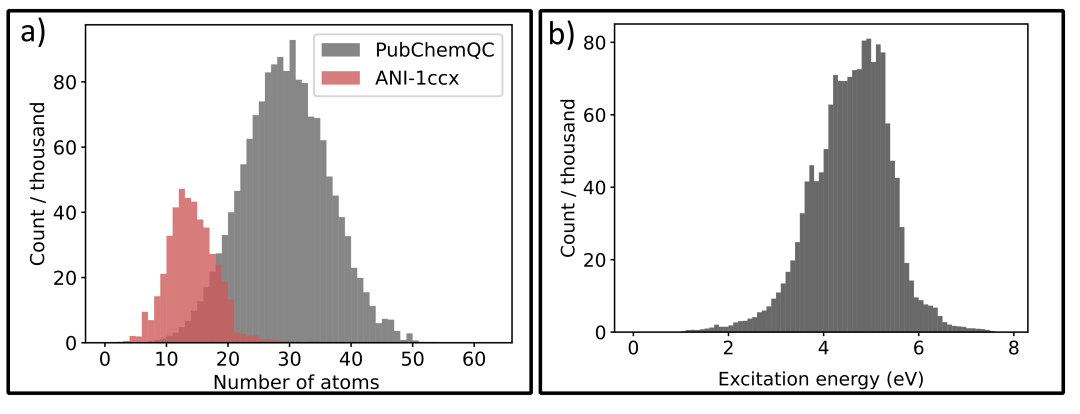
图3 | 用于训练OMNI-P2x的数据分布。(a) 训练集PubChemQC(激发态TD-DFT)和ANI-1ccx(基态CCSD(T))分子中原子数量的分布直方图(箱宽为1);(b) PubChemQC中第一激发能的分布(箱宽为0.1 eV)。
我们使用来自PubChemQC数据集的30万个未见分子测试集评估模型在激发能方面的性能,以及来自ANI数据集的近49,000个基态构象测试集。前11个电子态相对于TD-DFT数据的能量预测MAE表明,随着向更高激发态推进,预测质量提高,在S7处达到最小值。这里的一个异常值是S0,其能量MAE最小,为1.6 kcal/mol,我们将其归因于将全合一学习应用于包含基态DFT(来自PubChem)和CCSD(T)(来自ANI-1ccx)数据的组合集后数据效率的提高,以及基态能量分布总体上更光滑且方差更小,使其更易于模型学习。该基态MAE可与其他MLIP的类似指标相比较:ANI-1的RMSE为1.3 kcal/mol(OMNI-P2x为2.93 kcal/mol),UMA根据版本约为1至3 meV/原子(0.023至0.069 kcal/(mol·原子))(OMNI-P2x为0.11 kcal/(mol·原子)),AIMNet2报告中性化合物的MAE约为1.25 kcal/mol。虽然这些结果不能一对一比较,因为每个模型都在不同的数据集上训练和测试,但它们表明OMNI-P2x的基态误差保持在当前最先进机器学习衍生模型的合理范围内,尽管这不是本研究的重点。显示所有跃迁的预测与真实激发能相关图见补充材料。在所有情况下,R²均大于0.91。对于测试ANI-1ccx子集中的基态能量,OMNI-P2x具有更高的MAE(4.14 kcal/mol),但归一化能量的R²高达0.9966(未归一化为0.9999)。这是可以预期的,因为ANI-1ccx训练数据仅作为辅助数据集使用,其规模远小于PubChemQC,且具有不同的数据分布。
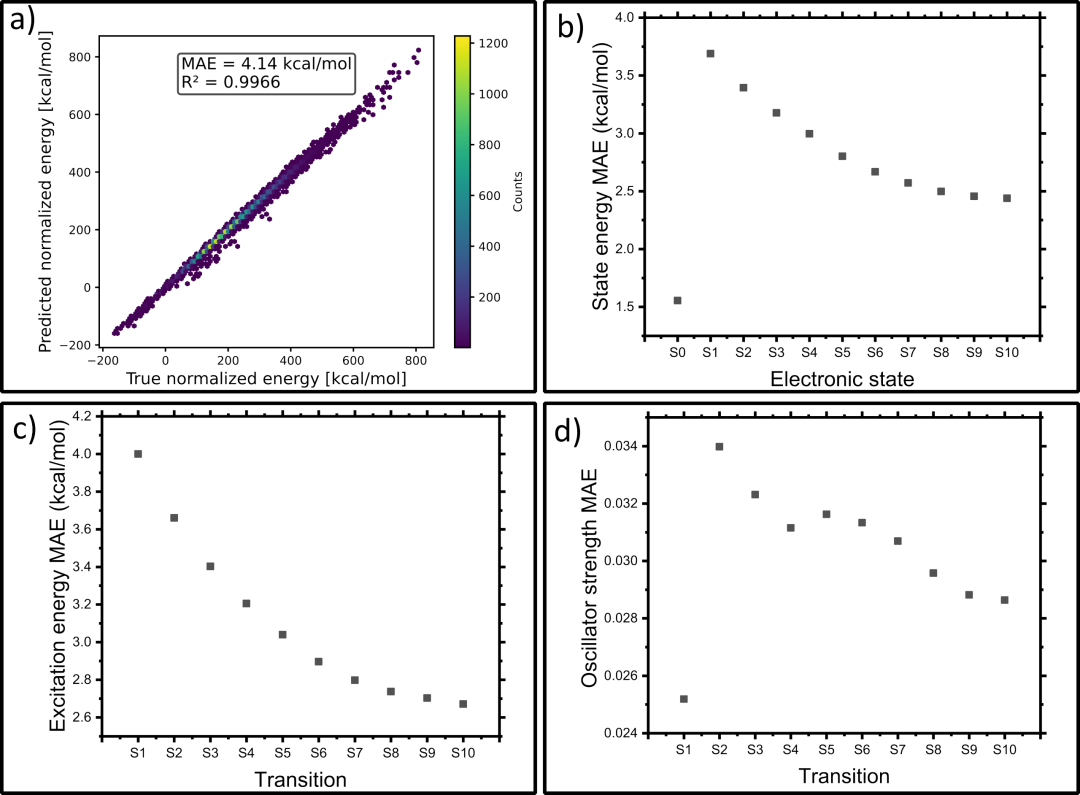
图4 | OMNI-P2x模型的测试性能。(a) ANI-1ccx数据集测试部分基态能量在CCSD(T)理论水平下参考值(真实值)与OMNI-P2x预测值的相关图;(b) 电子态能量的平均绝对误差(MAE);(c) 激发能的MAE;(d) 预测振子强度的MAE。
此外,OMNI-P2x提供所有预测能量的不确定性量化(UQ),使用三个NN势之间预测量的标准差作为误差棒。如果任何激发态的UQ超过安全阈值(对于每个电子态,该阈值确定为测试集UQ的中位数加上三倍中位数绝对偏差),则向用户发出警告。
最后,OMNI-P2x对振子强度的预测MAE在所有研究的电子态中均低于0.04。可以注意到,预测振子强度的最高精度在S1激发和更高的S8-S10态跃迁中实现。
紫外-可见吸收光谱
OMNI-P2x是一个通用模型,能够同时预测激发能和振子强度,即允许以QM质量获得紫外-可见激发光谱,但速度更快(详见方法部分)。
为测试OMNI-P2x模拟紫外-可见光谱的性能,我们从PubChemQC数据库生成50,000个测试分子的光谱,并将其与参考TD-DFT光谱进行比较(见方法部分)。首先让我们考察代表性光谱(图5)。
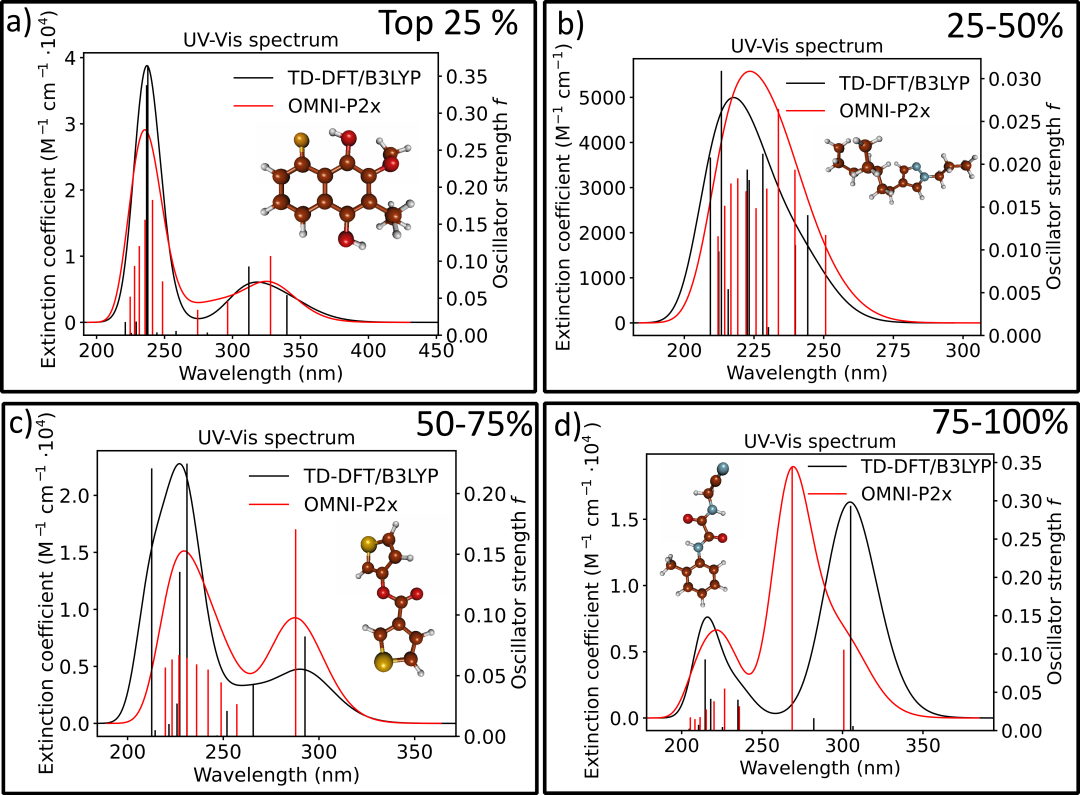
图5 | 参考TD-DFT/B3LYP光谱与OMNI-P2x预测光谱的比较。展示了四个随机选取的示例,分别来自预测光谱的前25%(面板a)、25-50%(面板b)、50-75%(面板c)和后25%(面板d)。
对于代表性测试分子,我们测试了有限温度畸变对OMNI-P2x精度的影响,发现较高激发态保持接近平衡基准,而最低激发(S1-S3)的精度可能更急剧下降。显示非平衡结构上误差分布的小提琴图见补充材料。为进一步探究这种行为,我们对环己酮(C=O伸缩)和偶氮苯(C-N=N-C扭转)进行了弛豫PES扫描。这些扫描证实OMNI-P2x在平衡附近和中等畸变下是准确的,但对于强烈压缩的几何结构或当扭转引起激发态特征变化时误差增大。综合来看,这些结果表明OMNI-P2x可以外推接近平衡的PES形状,但随着分子畸变将体系推向训练数据域之外,其可靠性降低。
为全面评估通用势的性能,我们还在相同的50,000个分子测试集上评估了两种常用的半经验QM方法:ODM2/CIS和TD-DFTB(图6)。
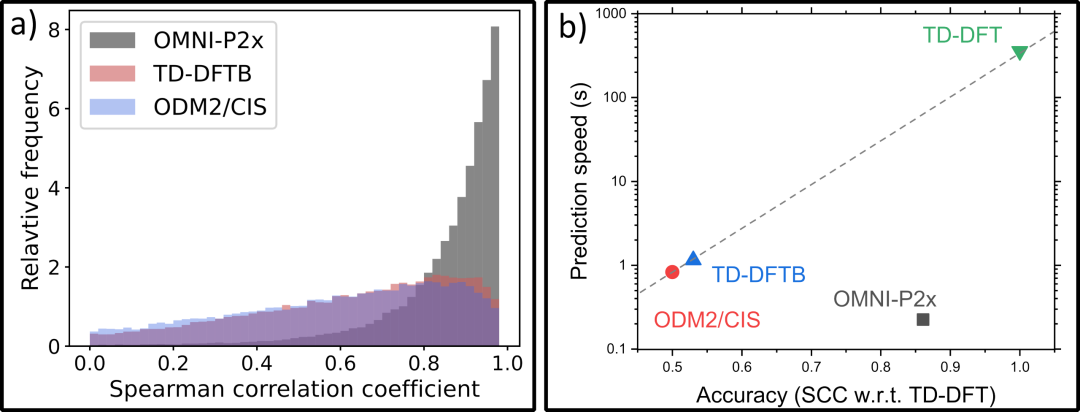
图6 | OMNI-P2x模型在50,000个分子测试集上预测紫外-可见吸收光谱的质量评估(基于基态平衡结构)。(a) 相关系数直方图,量化含时密度泛函理论(TD-DFT)与OMNI-P2x电子光谱之间的一致性,以及另外两种常用的低成本半经验QM方法:正交化与色散修正组态相互作用单激发方法(ODM2/CIS)和含时密度泛函紧束缚方法(TD-DFTB);(b) 方法成本与精度权衡的相关性比较。
OMNI-P2x光谱明显比半经验ODM2/CIS和TD-DFTB更接近参考TD-DFT,这从该测试集的Spearman相关系数分布可以判断。平均而言,OMNI-P2x和TD-DFT光谱彼此吻合良好,平均相关系数为0.86,80%的预测光谱相关系数大于0.80。相比之下,两种半经验QM方法的性能明显更差,TD-DFTB的平均SCC为0.53,ODM2/CIS为0.50。此外,ODM2的参数化仅限于仅由H、C、N、O、F原子组成的分子(50,000个结构中的39,164个),即OMNI-P2x比ODM2/CIS具有更广泛的元素覆盖范围。值得注意的是,OMNI-P2x不仅比半经验QM方法更准确,而且显然是现有方法中最快的,预测光谱的平均计算时间为225毫秒,而ODM2/CIS和TD-DFTB方法分别平均需要827毫秒和1152毫秒。参考TD-DFT计算慢数个数量级:每个预测光谱超过357.87秒。虽然QM方法遵循相对于精度近似指数标度的成本关系,OMNI-P2x打破了这种不利的标度关系。
核系综方法光谱
预测紫外-可见吸收光谱的一种更准确的方法是核系综方法(NEA)。在这种技术中,对数百或数千个分子几何结构的系综计算垂直激发能和振子强度。最终光谱通过在每几何结构的激发能处放置洛伦兹或高斯函数来构建,权重为相应的振子强度。与单点卷积相比,这种方法更好地捕捉振动效应。然而,NEA模拟计算量大,因为需要对系综中的所有结构进行量子力学计算。为解决这一成本问题,ML模型提供了自然的加速途径。由于OMNI-P2x仅在平衡结构的激发态数据上训练,它不能直接用于NEA模拟。尽管如此,微调使其在此情境中实现高数据效率和模拟速度,仅需25-50个额外的分子特定训练点即可复现参考光谱。
为证明这一点,我们考虑两个测试案例:吡嗪(含4个激发态)和9-二氰基亚甲基吖啶衍生物(9-DCMA,含30个激发态),后者此前曾用于基准测试ML-NEA光谱与核岭回归模型(详见方法部分)。使用参考TD-DFT数据以及仅训练了吡嗪25个数据点和9-DCMA 50个数据点的微调OMNI-P2x模型预测的NEA光谱见图7。
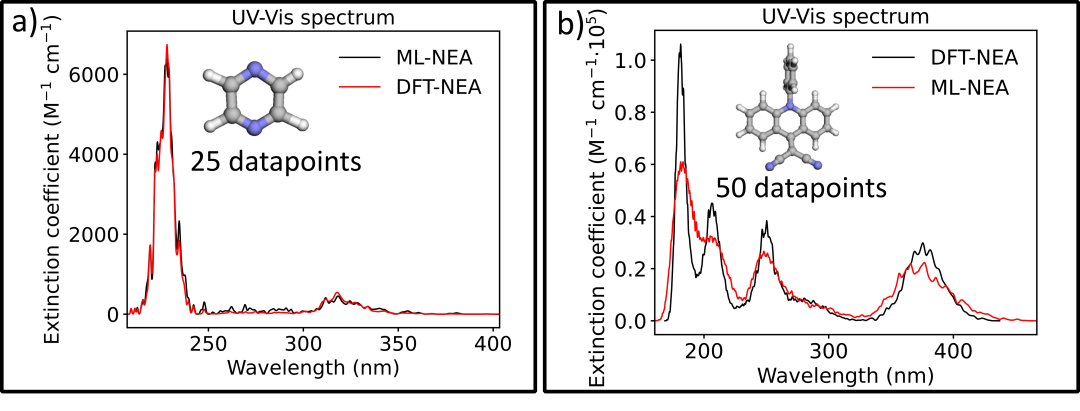
图7 | 使用OMNI-P2x的核系综方法光谱模拟。ML模拟(红色)与TD-DFT(黑色)光谱的比较:(a) 吡嗪;(b) 9-DCMA。
对于吡嗪(面板a),在整个光谱范围内观察到一致性。在更复杂的9-DCMA案例中,模型准确捕捉了较低激发态的强度和位置。偏差开始在250 nm以下出现,尤其是在预测强度方面,而峰位置保持相当准确。我们将其归因于模型在超出训练数据集中包含的激发态数量的范围进行外推:OMNI-P2x预训练在10个激发态上,而本例中考虑了30个。此类模拟可在普通硬件上(使用4个CPU的Jupyter笔记本)完成,吡嗪不到一分钟,9-DCMA约40分钟,不包括QM方法的标注时间。
ML预测的可解释性
为提供ML学习激发的可解释性,我们引入了一种分析激发能原子贡献的新方法。对于每个原子i,分数贡献定义为|ΔEi|/ΔE,其中ΔE是给定跃迁的激发能,原子贡献通过NN集成预测的基态和激发态原子能之差计算。我们表明,OMNI-P2x推导的原子贡献与参考TD-DFT密度差图吻合良好(图8)。这种分析允许我们通过识别哪些原子最参与跃迁来获得激发的空间特征。这种分析在概念上与Tkatchenko等人分析基态能量原子贡献的工作相关。
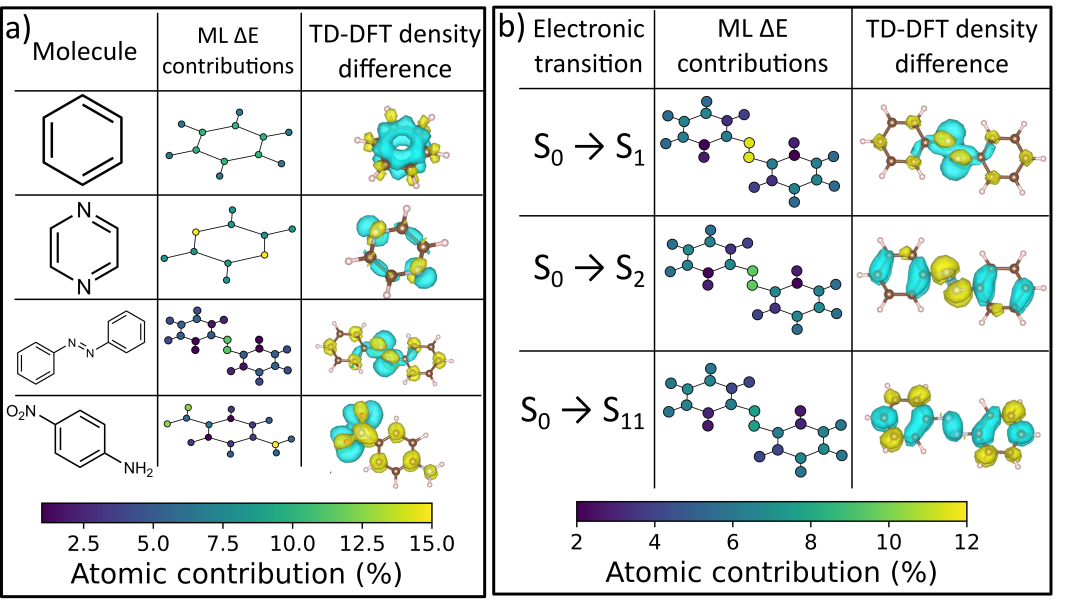
图8 | OMNI-P2x激发能的可解释性。(a) 显示几种不同有机分子激发能的原子分数贡献,与含时密度泛函理论(TD-DFT)密度差进行比较;(b) 同一分子(偶氮苯)的不同激发态。
我们证明这种可解释性分析可以在化学空间中以及同一分子的不同激发上良好工作。图8的面板a显示了若干有机分子的S0→S1 ML ΔE贡献和TD-DFT密度差。我们首先比较苯和吡嗪的例子,两个6-π电子芳香化合物。OMNI-P2x正确地将跃迁定位,在苯的所有碳原子上均匀分布,而在吡嗪上主要定域在两个氮原子上,复现了TD-DFT结果。激发还表现出适当的对称性:苯为C6,吡嗪为D2h。下一个例子偶氮苯显示激发在N=N双键上的物理正确定域,而在对硝基苯胺中部分电荷转移特征的激发态得到很好的复现。总体而言,这显示了ML预测的可解释特征,可在化学空间中迁移。
图8b显示了同一分子不同电子跃迁的原子贡献,以偶氮苯为例。OMNI-P2x正确地将S0→S1跃迁复现为定域在中心N=N键上,而S2跃迁具有来自芳香环的更大贡献。最后展示了更高的激发态(S11),它在整个共轭体系上离域。
上述分析手段不排除进行专门分析的需要,无论是手动还是使用基于波函数的工具如TheoDORE或Multiwfn,它们可以提供超出激发空间定域化的额外洞察,如轨道的特征。这些工具是互补的,因为OMNI-P2x实现的大规模模拟可作为生成足够统计数据的第一步,从中可抽取代表性样本,并进一步用基于波函数的工具进行后处理。
可见光吸收偶氮苯化合物的设计与筛选
OMNI-P2x的速度和精度使其适合对光活性分子体系进行高效的高通量筛选(HTS)。为展示OMNI-P2x在此类场景中的应用,我们对具有低能吸收特征的偶氮苯衍生物进行HTS。我们的选择基于此类化合物在非线性光学、光响应聚合物以及作为MOST体系方面的应用相关性。为此,首先我们使用RDkit以SMILES字符串形式生成了总计50万个偶氮苯衍生物(图9)。在此过程中,我们允许最多五个取代,取代基包括以下官能团:甲基、乙基、三氟甲基、硝基、羟基、巯基、氟、氯、胺基、腈基和羧基。三维结构(笛卡尔坐标)使用MLatom从SMILES生成,并使用快速准确的AIQM3模型进行优化(详见方法部分)。
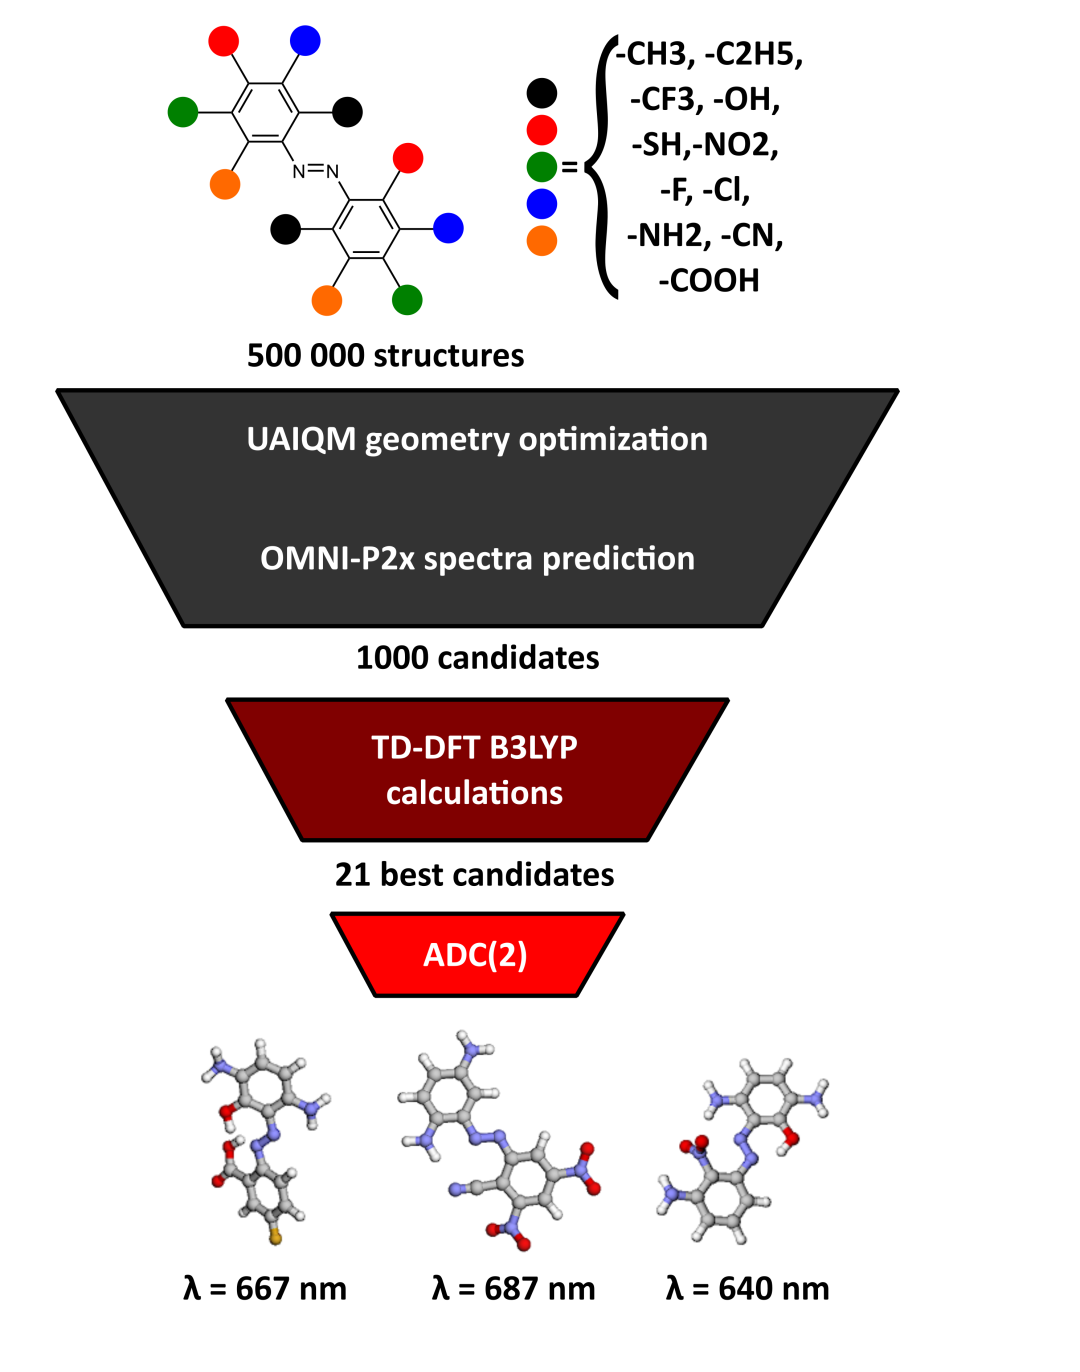
图9 | 红移可见光吸收偶氮苯衍生物高通量筛选流程总结。在生成的50万个结构中,通过在UAIQM优化结构上进行OMNI-P2x模型的迭代微调确定了1,000个候选结构,并计算其含时密度泛函理论(TD-DFT)光谱。该过程重复多次。对这些结构中的最佳候选者,使用二阶代数图解构造(ADC(2))方法计算了更高质量的光谱,最终得到21个紧凑的可见光吸收偶氮苯衍生物,图中展示了红移最多的三个化合物。
随后,我们用OMNI-P2x预测了优化结构的激发能。为改进OMNI-P2x预测的质量,从生成的集合中随机采样1,000个结构,并使用TD-DFT/B3LYP方法进行标注(理论水平详见方法部分)。然后,我们使用不同的训练/验证划分,在该集合上微调OMNI-P2x能量模型之一的两个副本。预测、选择和优化的过程又重复了两次,每次基于更新后的模型进行选择。将1,000个最不确定的分子加入训练集,不确定性通过两个训练模型之间的偏差来度量。当在1,000个随机采样结构上测试达到0.78的相关系数和0.25 eV的MAE时,我们停止了筛选过程的第一阶段,因为这一精度与目标TD-DFT方法的精度相似。对于微调模型预测的1,000个最低能吸收候选者,再次进行了TD-DFT预测。在这些结构中,总共确定了21个跃迁能低于2.0 eV的主要候选者(见支持材料)。由于这些分子中激发可能具有电荷转移特征,B3LYP泛函无法正确捕捉,我们在这一阶段使用更高水平的电子结构方法ADC(2)重新评估了21个主要候选者的激发能。
上述程序确定的三个最红移衍生物呈现在图9底部,而包含所有结构及其计算紫外-可见光谱的数据库可在支持材料中获得。三种研究理论水平预测光谱的比较见补充说明3。前三个衍生物的预测吸收能低于已报道的具有相同核心结构的人工设计红移偶氮苯单元的吸收能。同时,我们通过计算机筛选确定的最佳候选者与人工设计衍生物的取代模式显示出相似性,即邻位和对位的给电子基团 placement。
高效的机器学习驱动非绝热动力学
作为通用模型,OMNI-P2x有潜力加速非绝热动力学(NAMD)模拟,类似于基态模型如何用于高效执行基态动力学。然而,在这方面,应当指出NAMD不仅比基态动力学在计算上要求高得多,而且通常需要针对体系特定选择理论水平,因为常见的黑箱方法如TD-DFT无法正确描述激发态PES的关键特征,即第一激发态与基态PES的交叉。这通常需要适当选择更高级的QM方法,如CASSCF或CASPT2,它们需要为给定体系专门选择活性空间。由于我们的OMNI-P2x仅在TD-DFT数据上训练,在此我们不考虑直接使用它来传播NAMD,而是考虑一个更现实的场景:我们希望为特定问题(即所需的QM水平与体系的给定组合)微调OMNI-P2x。
为尽可能数据高效地进行微调,我们通过修改此前开发的主动学习流程来生成微调预训练通用势OMNI-P2x的数据,在主动学习循环的每次迭代中使用OMNI-P2x作为起点。从零开始执行直接主动学习(即为具有随机权重的神经网络势生成数据)迄今为止在ML驱动NAMD的时间和数据效率方面是最先进的,但即使对于相对简单的体系(如富烯或偶氮苯),仍可能需要数天到数周的实际耗时才能收敛。
作为我们的第一个测试体系,我们使用富烯(fulvene),它被广泛选为基准测试NAMD方法的原型分子。这一选择也使我们能够比较基于微调OMNI-P2x的新方案与之前使用具有随机初始权重的MS-ANI的最先进方案。作为参考电子结构方法,我们使用CASSCF(6,6)。NAMD使用Landau-Zener-Belyaev-Lebedev(LZBL)变体的TSH进行,它不需要计算非绝热耦合矢量(见方法部分)。通过在主动学习循环中微调通用势OMNI-P2x的主动迁移学习,我们能够将富烯的收敛时间从三天以上缩短到约24小时,计算效率提高约三倍。主动迁移学习仅产生3,550个构象,约为从零开始执行主动学习流程达到收敛所需训练点数量的一半(图10a)。此外,检查电子态布居的时间演化,我们可以看到微调模型和先前MS-ANI模型预测的布居之间存在统计学显著差异。尽管训练集更小,OMNI-P2x的迁移学习版本更好地捕捉了体系的光物理行为。使用不同ML模型和不同LZBL传播设置预测的动力学与参考最少 switches 面跳跃动力学的比较见补充说明4。富烯NAMD轨迹的进一步分析,包括ML预测势能面、最小能量锥形交叉以及跳跃点和失活通道的比较,见补充说明4.1。在所有情况下,ML模型与参考CASSCF计算之间均观察到一致性。
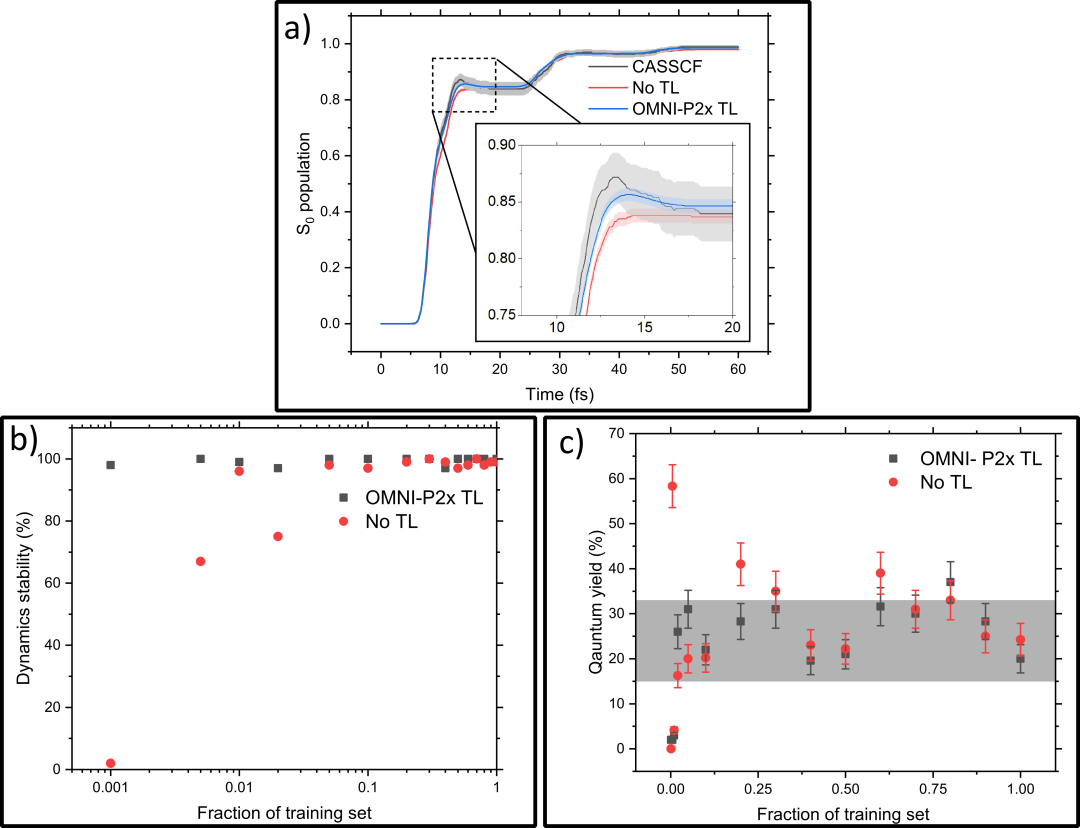
图10 | 微调OMNI-P2x在NAMD模拟中的性能。(a) 富烯的基态布居演化,来自使用主动学习循环中从头训练的ML模型(红线)和通过微调OMNI-P2x(蓝线)传播的NAMD轨迹,以及参考完全活性空间自洽场方法(CASSCF)动力学(黑线),带阴影的95%置信区间误差棒;(b) 偶氮苯光开关NAMD模拟的稳定性随完整主动学习数据集的变化;(c) 使用不断增加的训练集比例训练的模型预测的光异构化量子产率,阴影区域对应参考方法的预测。TL-迁移学习。误差棒使用二项过程的正态近似区间估计,置信区间为95%。
当转向更复杂的主动学习案例时,这种改进更加显著。一个这样的例子是在AIQM1/MRCI-SD理论水平模拟的偶氮苯光异构化反应。由于在此过程中覆盖的化学空间体积庞大,学习光反应是一项特别困难的任务。为评估使用预训练通用模型带来的数据效率改进,我们比较了微调的OMNI-P2x和从零开始训练的MS-ANI在收敛AL流程所需完整训练集的不同分数上的表现(35,071个点,如参考文献所报告)。从动力学稳定性来看(计算为未完成解离的轨迹百分比),微调OMNI-P2x模型仅需数据集的0.1%即可传播稳定的动力学,而使用纯学习方法传播的动力学在超过10%数据后才变得持续稳定(图10b)。此外,图10c展示了反式到顺式光异构化的预测量子产率随训练集大小的变化。对于迁移学习势,所有在超过2%数据上训练的模型预测的QY均在参考范围内,达到95%置信区间误差棒。另一方面,从零开始训练的模型表现则一致性差得多,即使在训练集的高分数下也有离群值预测错误的量子产率。偶氮苯S0和S1 PES、优化MECI和失活几何的分析见补充说明4.2,以及与参考结果的比较,这些结果与ML模型一致。
上述发现突出表明,OMNI-P2x在庞大数据集上的预训练使其能够获得化学化合物空间的知识以及构象空间的部分信息,大大减少了其微调所需的数据量。这使得OMNI-P2x成为经过数据高效微调后传播ML加速面跳跃动力学的首选方法。类似现象已在参考文献中报道,其中在基态数据上预训练的神经网络势在低数据状态下可比从零开始训练的势实现更低的激发态预测MAE。
讨论
我们提出了OMNI-P2x:一种用于预测关键分子激发态性质(包括能量、力和振子强度)的通用ML势。该模型能够开箱即用地预测有机分子的电子光谱,瞄准TD-DFT/B3LYP理论水平,精度约为0.15 eV。重要的是,OMNI-P2x比常用的激发态半经验QM方法提供更高质量的光谱预测,同时计算成本大幅降低。这种电子光谱预测中的效率和精度使得对具有所需性质的光活性分子体系进行高通量筛选成为可能:我们通过筛选50万个偶氮苯衍生物以寻找红移可见光吸收光开关来展示这一点。筛选得到了三个在比以往报道的偶氮苯衍生物更长波长区域吸收的顶级候选物。
与所有机器学习原子间势一样,OMNI-P2x的精度只能与其训练所用的参考方法一样高。在我们的情况下,这是TD-DFT/B3LYP/6-31+G,它在精度和跨大化学空间的计算可行性之间提供了实际的平衡,但已知在某些激发态性质方面存在困难——最显著的是电荷转移和Rydberg激发。在小型分子中,使用如6-31+G这样的中等基组可能进一步加剧这一问题,因为较高激发可能对应于描述不佳的Rydberg态。因此,TD-DFT/B3LYP相对于实验基准或理论最佳估计(TBE)通常介于0.2至0.4 eV之间的预期误差水平将被保留。振子强度同样如此,相对于TBE报告的MAE介于0.05至0.15之间。我们通过提供ADC(2)与TD-DFT/B3LYP垂直激发能的比较来补充这些基准(见补充图19和补充表3)。DFT结果与ADC(2)良好相关,显示出系统性低估激发能,这种低估在向更高激发态推进时增加。这些限制是参考数据固有的,因此传播到训练模型中。此外,神经网络模型预期主要为大小和化学组成与训练集中所代表的分子相似的分子产生可靠预测;外推到显著更大或化学上不同的分子可能导致非物理或意外结果。然而,OMNI-P2x在理论水平方面完全中性,当有更准确的数据可用时可以进行微调;事实上,我们在本工作中表明,从TD-DFT/B3LYP出发的迁移学习在适配到更高级参考方法时已经改进了性能。
重要的是,我们展示了OMNI-P2x通用模型可用于加速和增强ML驱动NAMD模拟的稳健性。为此,我们开发了一种在主动学习循环中微调OMNI-P2x的方案,与从零开始的主动学习相比,数据效率提高高达十倍。所得ML驱动NAMD的质量与不使用OMNI-P2x的ML-NAMD相比得以保持甚至改进。OMNI-P2x中的预训练权重包含庞大化学化合物和构象空间的知识,这赋予ML驱动NAMD比使用从零开始训练的网络进行的ML动力学更高的稳定性。这一优势已在后续研究中被利用,使得能够使用无解析梯度的电子结构方法(如QD-NEVPT2)进行NAMD模拟。
虽然OMNI-P2x是第一个通用激发态神经网络势,但它自然具有进一步提升的空间。扩展训练集可以支持更广泛的元素类型和非平衡结构。框架的未来扩展将旨在不仅预测单重态流形中的中性分子,还预测更高多重度的态和带电物种。尽管当前对单重态的关注已经能够为许多光物理应用提供准确且化学多样的预测,但该架构本身是可扩展的,这些附加能力将是未来工作的主题。
此外,开发一个无需微调即可跨化学空间执行NAMD模拟的通用势仍然是一项艰巨任务,原因在于光化学转化的多样性、锥形交叉直接附近分子构象的高度变化、QM水平的多种可能选择以及QM水平内部的设置(如活性空间),这将需要广泛的训练数据以及可能的架构额外修改。在此期间,本文提出的将OMNI-P2x微调与主动学习相结合的方案可以通过为手头问题提供特定解决方案来实质性地缓解这一问题。
方法
模型训练与数据收集
完整的PubChemQC数据集从PubChemQC项目获取。PubChemQC数据集中的分子在B3LYP/6-31G水平下优化,激发态性质使用GAMESS以TD-B3LYP/6-31+G计算。每个分子计算了前11个电子态,得到10个激发能和振子强度。
本研究中,从PubChemQC数据集中选择了满足以下条件的分子:多重度为1,净电荷为0,具有11个电子态的TD-DFT数据,并包含C、H、O、N、F、S和Cl元素。所得数据集包含310万个分子,我们使用MLatom 3.16.2将其编译为MLatom原生机器可读数据库格式并保存为JSON文件,用于本研究的训练和测试。
训练期间,使用仅能量的MSE损失函数:
L = (E_ML − E_ref)²
其中E_ML和E_ref分别是ML预测和参考能量。
类似地,用于振子强度训练的模型使用振子强度的MSE损失。
紫外-可见光谱预测
电子紫外-可见吸收光谱使用基于展宽函数的标准单点卷积近似获得:
L(x) = 0.619 · Σ_i (f_i · Γ) / (e^(-(x−x_i)/Γ))
其中x_i是预测的跃迁能,f_i是其振子强度,Γ是预定义的半高全宽参数(FWHM)。本工作中使用0.3 eV的展宽参数。
不同方法预测的电子光谱使用Spearman秩相关系数(SCC, r_SCC)进行比较:
r_SCC = 1 − (6 Σ_i d_i²) / (n(n²−1))
其中d_i是两个光谱之间的秩差,n是光谱的总长度。ODM2/CIS光谱使用MLatom与MNDO程序包的接口计算,TD-DFTB光谱使用与DFTB+程序(版本24.1)的接口获得,使用3ob-3-1参数集。
为处理被大于分子描述符截断半径的距离分隔的非共价结合结构,我们引入了碎片修正方案。该方法检查非共价结合的碎片,并比较整个体系与单个碎片的激发能,以确定该态对应于定域激发还是激基复合物。对苯二聚体作为分子间距离函数的验证表明,修正后的模型与TD-DFT/B3LYP参考值吻合良好,而当部分体系落在截断半径之外时,未修正模型则出现分歧。完整细节见补充说明1。
对于核系综方法光谱,使用MLatom实现的298 K Wigner分布采样了500个吡嗪构象,并使用Gaussian 16.0(Revision C.01)软件包以TD-DFT/B3LYP(6-31+G*)进行标注。几何优化使用geomeTRIC包进行,频率计算使用PySCF。9-DCMA体系的数据从参考文献提取,该数据在CAM-B3LYP/ma-TZVP理论水平计算。
补充材料中展示的分子热畸变结构从2 ps长的基态Born-Oppenheimer分子动力学轨迹中采样(前1 ps丢弃用于热化),在GFN2-xTB理论水平下进行。所有计算和图表均使用MLatom准备。
NAMD模拟
用作TSH模拟参考方法的CASSCF计算通过COLUMBUS量子化学程序包的接口进行,使用6个电子在6个轨道中的活性空间。TSH模拟使用Landau-Zener-Belyaev-Lebedev形式进行,态k和j之间的跳跃概率P_{j→k}使用以下公式计算:
P_{j→k} = exp(−(π/2ℏ) · √(Z_jk³ / Z̈_jk))
其中Z_jk是态j和k之间的能量差,Z̈_jk是其二阶时间导数。
主动学习循环使用参考文献中呈现的标准设置,初始点从谐波近似Wigner分布采样,共250个点。最大传播时间设置为60 fs,时间步长为0.1 fs。跳跃后的速度在动量矢量方向上重新标度,使用缩减动能储备。在AL流程的每次迭代中,运行50条ML-TSH轨迹和50条gapMD轨迹。基于跳跃概率不确定性额外采样15个点,最多到300个点的阈值。
模型测试使用MS-ANI模型以及微调的OMNI-P2x模型各10,000条轨迹,以及623条CASSCF(6,6)轨迹作为参考。OMNI-P2x能量集成中的一个模型用于所有NAMD应用的微调。对于两个研究的体系,初始条件通过从MLatom实现的298K Wigner分布采样生成,使用与吡嗪相同的优化和频率软件。
偶氮苯动力学的参考数据使用AIQM1/MRCI-SD方法标注。在AIQM1的半经验部分,SCF步骤使用半电子限制开壳层Hartree-Fock形式,使用单占据HOMO和LUMO轨道。在MRCI过程中加入两个额外的闭壳层参考:一个HOMO-HOMO组态和一个双激发LUMO-LUMO组态。活性空间由10个轨道中的8个电子组成(四个占据轨道,六个非占据轨道)。允许在如此定义的活性空间内进行单激发和双激发。对反式→顺式和顺式→反式光异构化反应各运行并分析了100条轨迹。测试从零开始训练的模型时使用相同数量的轨迹。
模拟量子产率Φ计算为弛豫形成光产物(另一种异构体)的轨迹数N_reactive与总轨迹数N_traj之比:Φ = N_reactive/N_traj。
偶氮苯筛选
所有计算均使用XACS版本的MLatom(现为含Aitomic附加组件的MLatom)进行。我们使用MLatom与TorchANI包的接口处理所有基于ANI型网络及其修改的模型(即MS-ANI、OMNI-P2x和AIQM3)。AIQM3计算还使用MLatom与s-dftd3程序的接口(提供D3(BJ)修正)和xtb程序(提供GFN2-xTB*基线,即不含D4色散修正的GFN2-xTB)。偶氮苯衍生物使用瞄准CCSD(T)/CBS精度的UAIQM模型的AIQM3版本进行优化;该模型通过Aitomic包提供的MLatom附加组件可用。对于TD-DFT计算,使用MLatom与Gaussian 16软件包(Revision C.01)的接口。ADC(2)水平光谱使用Turbomole软件包计算,使用Dunning相关一致性双ζ基组(cc-pVDZ)。
数据可用性
PubChemQC和ANI-1ccx数据集分别公开可得于https://doi.org/10.1038/s41597-020-0473-z。支持本研究发现的数据,包括偶氮苯衍生物的筛选和非绝热分子动力学轨迹,已存储于Figshare:https://doi.org/10.6084/m9.figshare.28794599。源数据在本文中提供。
代码可用性
代码在开源MLatom中以MIT许可证提供,详见https://github.com/dralgroup/mlatom,OMNI-P2x模型权重和与本出版物相关的脚本可在专用仓库中以MIT许可证获取:https://github.com/dralgroup/omni-p2x。计算也可在https://atom.xmu.edu.cn和Aitomistic Hub(https://aitomistic.xyz)上在线进行,配有便捷的图形用户界面和Aitomia(或其后续版本如[Protomia](/protomia))——通过自然语言提示协助模拟的AI智能体。
致谢
M.M.感谢波兰教育与科学部在"Perły Nauki"计划(项目编号PN/01/0064/2022)下对本研究的资助,项目资助金额及总价值:239,800.00波兰兹罗提,同时感谢波兰高性能计算基础设施PLGrid(HPC中心:ACK Cyfronet AGH)在计算项目PLG/2024/017363范围内提供计算设施和支持。P.O.D.感谢国家自然科学基金委员会国际资深科学家项目(项目号:W2531013)和优秀青年科学基金项目(海外,2021)的资助,以及固体表面物理化学国家重点实验室项目的资助和深圳Aitomistic的资助。部分计算在Xiamen Atomistic Computing Suite云服务器(http://XACScloud.com,现由Aitomistic Lab@XMU接替,位于https://atom.xmu.edu.cn)上完成。作者还感谢陈宇欣欣在AIQM3方法发表前提供了用于优化偶氮苯衍生物几何结构的更高质量版本。
作者贡献
M.M.开发了用于训练OMNI-P2x和MS-ANI模型的代码,测试了收集的数据集,进行了模型训练、基准测试和测试,进行了微调实验,设计了筛选流程并进行了所需的计算和模型训练,开发了用于TSH的改进主动学习方案并进行了NAMD模拟,分析了结果,撰写了稿件的原始版本并准备了图表。X.Y.T.进行了数据收集和通过MS-ANI模型训练对其质量的初步评估,实现了用于TD-DFTB计算的DFTB+接口,并协助优化偶氮苯衍生物。J.J.参与了结果分析和解释,共同指导了研究,并协助撰写稿件的原始版本。P.O.D.设计并构思了项目,对结果分析和解释做出了贡献,共同指导了研究,撰写了稿件的初步大纲、标题和摘要,并获得了资助。所有作者讨论了结果,为稿件及其修订做出了贡献。
利益冲突
作者声明无利益冲突。
免责声明: 本文在拟核科技 Protomia 的协助下完成编辑、中文翻译及适当内容扩展,基于原文进行适应性改写。原文发表于 Nature Communications,采用知识共享署名 4.0 国际许可协议(Creative Commons Attribution 4.0 International License)。如需获取完整版本(含参考文献),请查阅原文:Martyka, M., Tong, XY., Jankowska, J. et al. OMNI-P2x universal neural network potential for excited-state simulations. Nat Commun 17, 4949 (2026). https://doi.org/10.1038/s41467-026-71380-5。